import random
random.seed(42)
data = [random.gauss(100, 15) for _ in range(50)]
print(f"Generated {len(data)} observations")Generated 50 observationsprint(f"Range: [{min(data):.1f}, {max(data):.1f}]")Range: [60.7, 119.7]When a document contains many code blocks, referencing specific pieces of code can be challenging. The number-blocks option adds sequential labels – “Code Block 1,” “Code Block 2,” and so on – making it to reference code in discussions, reviews, or assignments.
extensions:
  regurgitate:
number-blocks: trueimport random
random.seed(42)
data = [random.gauss(100, 15) for _ in range(50)]
print(f"Generated {len(data)} observations")Generated 50 observationsprint(f"Range: [{min(data):.1f}, {max(data):.1f}]")Range: [60.7, 119.7]# Remove outliers beyond 2 standard deviations
mean_val = sum(data) / len(data)
std_val = (sum((x - mean_val)**2 for x in data) / len(data)) ** 0.5
lower = mean_val - 2 * std_val
upper = mean_val + 2 * std_val
cleaned = [x for x in data if lower <= x <= upper]
removed = len(data) - len(cleaned)
print(f"Removed {removed} outliers")Removed 1 outliersprint(f"Remaining: {len(cleaned)} observations")Remaining: 49 observationsn = len(cleaned)
mean_clean = sum(cleaned) / n
median_clean = sorted(cleaned)[n // 2]
std_clean = (sum((x - mean_clean)**2 for x in cleaned) / (n - 1)) ** 0.5
print("=== Final Statistics ===")=== Final Statistics ===print(f"N: {n}")N: 49print(f"Mean: {mean_clean:.2f}")Mean: 99.91print(f"Median: {median_clean:.2f}")Median: 101.66print(f"Std: {std_clean:.2f}")Std: 10.82# Histogram with normal curve overlay
set.seed(42)
cleaned <- rnorm(47, mean = 100, sd = 14) # Simulated cleaned data
hist(cleaned,
freq = FALSE,
main = "Distribution of Cleaned Data",
xlab = "Value",
col = "lightblue",
breaks = 10)
curve(dnorm(x, mean = mean(cleaned), sd = sd(cleaned)),
add = TRUE, col = "darkblue", lwd = 2)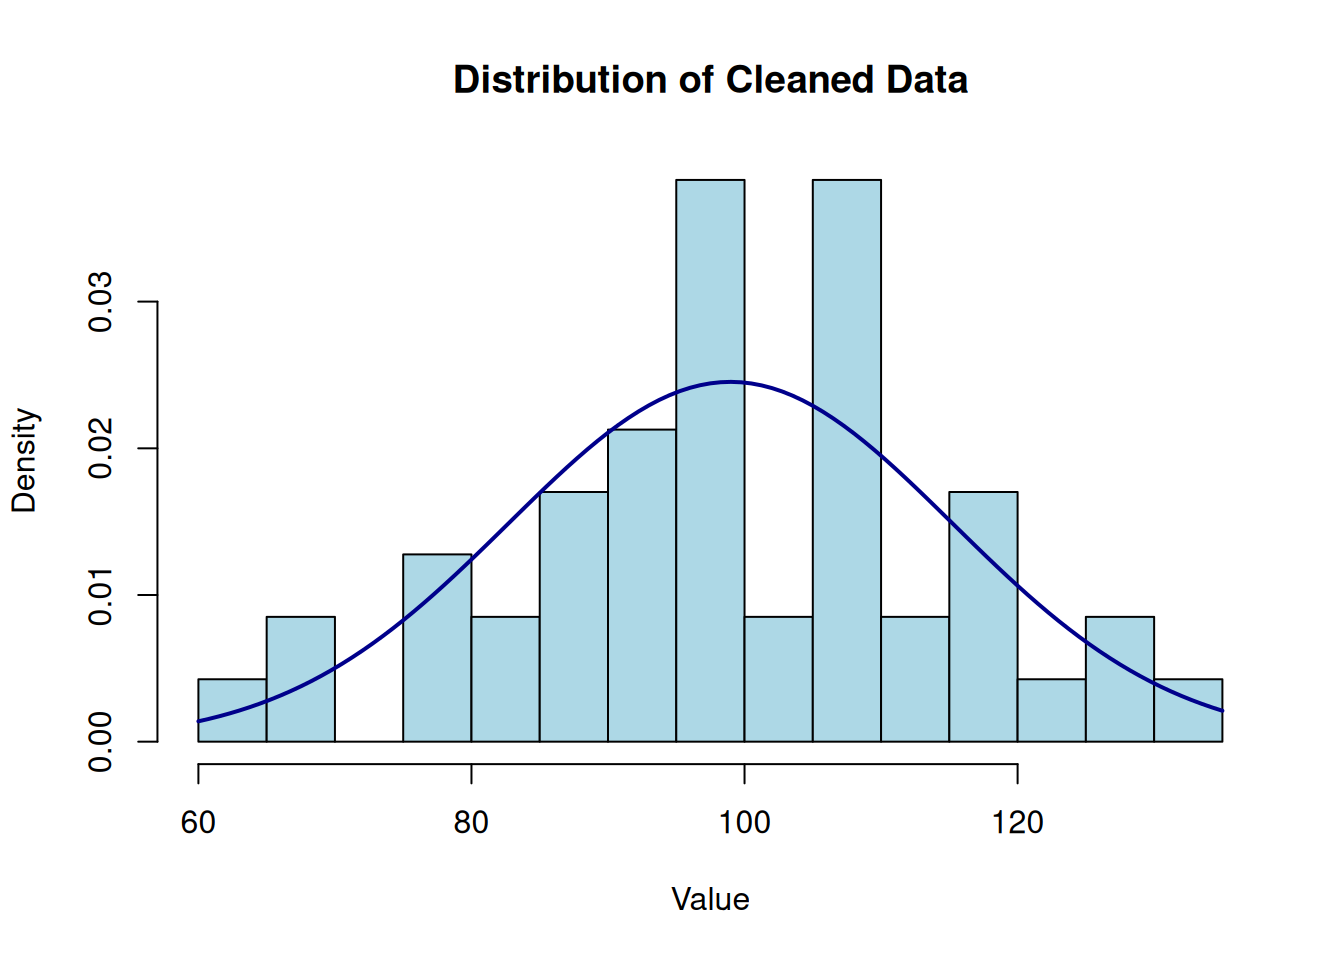
Each block in the appendix below is numbered (Code Block 1, Code Block 2, etc.). This makes it easy to say “see Code Block 2 for the outlier removal logic.”
Code Block 1 (yaml)
extensions:
regurgitate:
number-blocks: trueCode Block 2 (python)
import random

random.seed(42)
data = [random.gauss(100, 15) for _ in range(50)]
print(f"Generated {len(data)} observations")
print(f"Range: [{min(data):.1f}, {max(data):.1f}]")Generated 50 observationsRange: [60.7, 119.7]Code Block 3 (python)
# Remove outliers beyond 2 standard deviations
mean_val = sum(data) / len(data)
std_val = (sum((x - mean_val)**2 for x in data) / len(data)) ** 0.5

lower = mean_val - 2 * std_val
upper = mean_val + 2 * std_val

cleaned = [x for x in data if lower <= x <= upper]
removed = len(data) - len(cleaned)

print(f"Removed {removed} outliers")
print(f"Remaining: {len(cleaned)} observations")Removed 1 outliersRemaining: 49 observationsCode Block 4 (python)
n = len(cleaned)
mean_clean = sum(cleaned) / n
median_clean = sorted(cleaned)[n // 2]
std_clean = (sum((x - mean_clean)**2 for x in cleaned) / (n - 1)) ** 0.5

print("=== Final Statistics ===")
print(f"N: {n}")
print(f"Mean: {mean_clean:.2f}")
print(f"Median: {median_clean:.2f}")
print(f"Std: {std_clean:.2f}")=== Final Statistics ===N: 49Mean: 99.91Median: 101.66Std: 10.82Code Block 5 (r)
# Histogram with normal curve overlay
set.seed(42)
cleaned <- rnorm(47, mean = 100, sd = 14)  # Simulated cleaned data

hist(cleaned,
     freq = FALSE,
     main = "Distribution of Cleaned Data",
     xlab = "Value",
     col = "lightblue",
     breaks = 10)

curve(dnorm(x, mean = mean(cleaned), sd = sd(cleaned)),
      add = TRUE, col = "darkblue", lwd = 2)